10 月 27 日到 28 日这 48 小时,AI 圈出现了两个方向完全相反的动作:谷歌把最强的模型锁起来,只交给少数人;一家小公司把六个小模型全部放到网上,谁都能下载。差别不在技术,在分发给谁。
一、59 分,和一张不对外卖的门票
10 月 28 日,谷歌发布新一代旗舰模型 Gemini 4 Carbon。第三方评测机构 Artificial Analysis 用一套叫"智能指数"的综合打分给它打了 59 分,排在全球第一。
这个分数要放在刻度里看。它不是百分制——这套题很难,目前全球最强的几个模型都挤在 60 分以下:第二名 Anthropic 的 Claude Opus 5.5 是 58 分,第三名 OpenAI 的 GPT-6 Astra 是 57 分,而谷歌自己上一代的 Gemini 3 Argon 只有 50 分。一代提升 9 分,是不小的跨度。
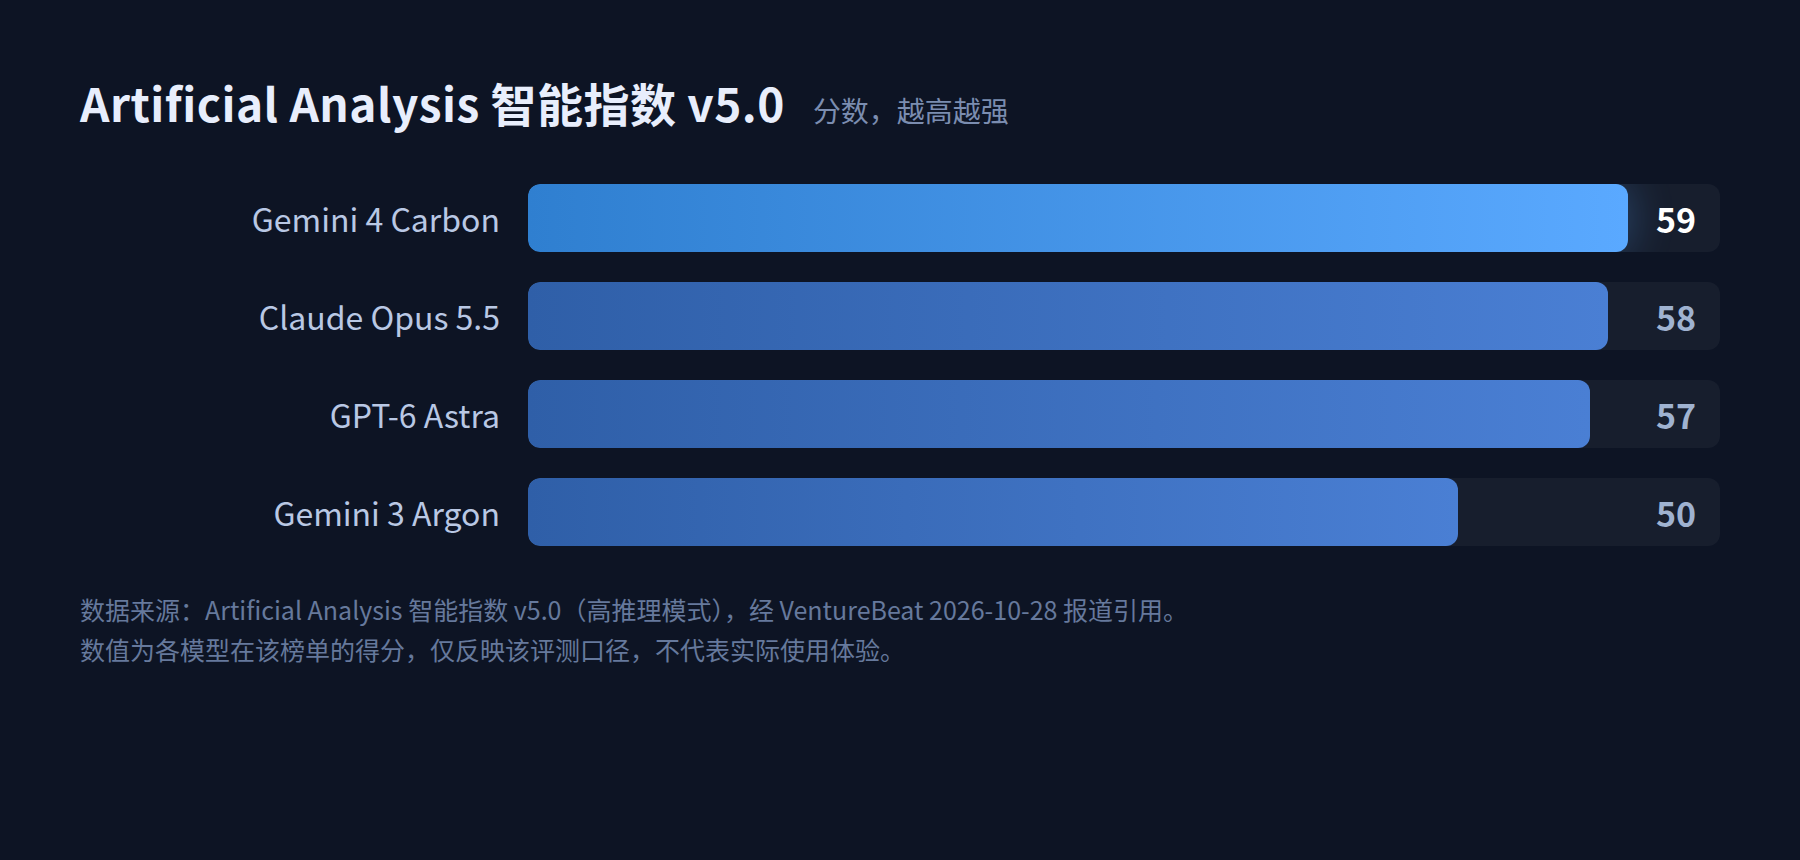
数据来源:Artificial Analysis 智能指数 v5.0,经 VentureBeat 报道引用。这套指数不设及格线,分数只反映该评测口径。
但普通人用不到。Carbon 目前只开放给谷歌 Fairwind 计划内选定的网络安全机构。谷歌的说法是,要先"收集反馈、迭代护栏",再向公众放行。
价格也留了后手。现在每百万 token 输入 2 美元、输出 10 美元,官方脚注写明之后会恢复成 4 美元和 20 美元——也就是翻倍。
分数第一,不等于全面第一。VentureBeat 引用的独立测试显示,Carbon 在编程和知识工作上比 Argon 提升明显,但在一些专业任务上不如对手。综合分领先 1 分,换一个维度就可能翻过来。
顺带一提,同一批发布里还有世界模型 Genie 4——能实时生成可以进去玩的虚拟场景,官方说用于机器人训练和影视预览。它同样不是给普通人用的东西。
二、为什么先给防守方
一家公司把最强的模型先交给防御方,而不是付钱的客户,可以有三种解释:这是发布前的安全评估流程;算力不够,只能小范围供给;或者它真的认为这个模型的破坏力已经超过了商业价值。
谷歌没有说明是哪种。我们能做的是看它多久放开——如果三个月后仍是小范围,那第一种解释就站不住了。
三、另一条路:把能力做小,然后放出来
Liquid AI 开源了 LFM3 系列,首批六个模型,每个只有 20 亿参数。"参数"可以粗略理解成模型的脑容量:今天大厂旗舰动辄是它的几十倍,所以 20 亿在行业里算小。
但小不等于不能干正事。这六个模型分别管文字、图片和视频、声音、以及决策,共用一套新架构,训练时读了 22 万亿个 token(token 是 AI 读写文字的最小单位)。它们能跑在手机、树莓派、笔记本、高通芯片等 14 种设备上。
获取方式也很直接:模型的"安装包"(行业里叫权重)已经放到开源模型站 Hugging Face,任何人可以免费下载;不想自己部署的,也能直接调用在线接口试用。
更关键的是下游已经有人接住了。Frigade 开源了 Hob,一个本地 AI 客户端,Mac、Windows、Linux 都能装,断网也能用。它会先读你的机器配置,自动挑一个跑得动的开源模型装好,然后你就能拿它读 PDF、填表格、整理文档——数据不出本机。
过去常说"开源模型很强但难用",现在这两件事凑在一起,通路就完整了:有人把能力做小,有人负责把它装到你机器上。
四、榜单之外,还有两件事
微软发布 MAI-Image-2.7-Preview,在 Artificial Analysis 的图像编辑榜上超过 OpenAI 的 GPT Image 2.5 升到第二。综合能力的差距越来越小,胜负开始取决于某一个具体任务——这对用的人来说未必是好消息,因为"哪个更好"越来越取决于你要它干什么。
OpenAI 那边公布了三项由 AI 辅助完成的发现,落在数学、计算机科学和物理。但研究者的反应不是赞叹,而是质疑:只给了有限访问,没提供可以独立验证的材料(The Verge 和 Engadget 都记录了)。"突破"这个词,只有在别人能复现的时候才成立。
还有个小工具值得一提:Weir 专门查 AI 助手有没有把你的 API 密钥泄漏出去,往项目里植入假密钥、跑一遍真实流程就能看出漏在哪。一行 pip install 装完,作者说靠它发现了 MLflow(一个常见的机器学习平台)的一个漏洞。
开源把能力放出来了,代价也一起放出来了。这类补漏的工具,现在比新模型更缺。
五、所以,这事跟你有关系吗
如果只看榜单,今天最强的是 Gemini 4 Carbon。但如果你现在想用它,答案是:不能。
对你的实际影响:手机里那个 AI 助手,接下来几个月大概不会突然变强一大截——最强的那个还没轮到公众。但反过来,能装在自己设备上、不联网也能跑、数据不外传的 AI,会比以前好用不少。这个你过一阵就能自己验证。
对开发者的影响:选择变成三条。等大厂放行,可能等很久;花更贵的钱买对手的旗舰;或者拿这种小模型自己调,用能力上限换成本和自主权。
我的判断是:能力正在按"能不能被信任"分配,而不是按"谁出价高"分配。这个判断对不对,有两个可以验证的指标——Carbon 多久对公众开放,以及 Liquid AI 会不会推出更大尺寸的版本。如果半年后前者仍然只给少数机构、后者一路往大做,那说明这套分发逻辑是真的。
榜单回答的是"谁最强",不回答"你能不能用"。这次两者的差距,是最近一年最大的一次。
评论